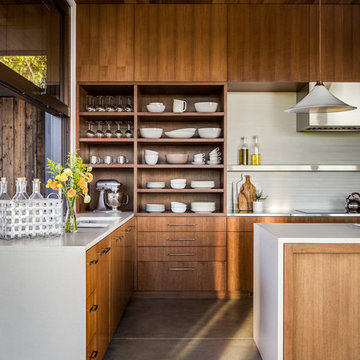
Kitchens4,222 ideas

Bathrooms2,442 ideas
Kids Rooms1,868 ideas
Bedrooms1,657 ideas
Powder Rooms1,638 ideas
Family Rooms1,414 ideas
Dining Rooms1,403 ideas
Laundry1,361 ideas
Basements1,338 ideas
Entries1,286 ideas
Home Bars1,168 ideas
Hallways1,131 ideas
Home Offices1,098 ideas
Living Rooms1,038 ideas
Nurseries923 ideas
Closets & Storage922 ideas
Sunrooms851 ideas
Decks792 ideas
Discover
Fresh ideas from your catalog
More from the web


![[논문 리뷰] NORA-1.5: A Vision-Language-Action Model Trained using World ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/nora-15-a-vision-language-action-model-trained-using-world-model-and-action-based-preference-rewards-0.png)


![[논문 리뷰] Unified Vision-Language-Action Model](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/unified-vision-language-action-model-0.png)


![[PDF] EdgeVLA: Efficient Vision-Language-Action Models | Semantic Scholar](https://figures.semanticscholar.org/51bdc605dfb54f7227d677c615f49a8f94fe6402/2-Figure1-1.png)


![[論文レビュー] DriveMoE: Mixture-of-Experts for Vision-Language-Action Model ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/drivemoe-mixture-of-experts-for-vision-language-action-model-in-end-to-end-autonomous-driving-1.png)
![[Revisión de artículo] Probing a Vision-Language-Action Model for ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/probing-a-vision-language-action-model-for-symbolic-states-and-integration-into-a-cognitive-architecture-2.png)

![[論文レビュー] RotVLA: Rotational Latent Action for Vision-Language-Action Model](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/rotvla-rotational-latent-action-for-vision-language-action-model-1.png)

![[논문 리뷰] $π_{0.5}$: a Vision-Language-Action Model with Open-World ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/05-a-vision-language-action-model-with-open-world-generalization-0.png)

![[PDF] OpenVLA: An Open-Source Vision-Language-Action Model | Semantic ...](https://figures.semanticscholar.org/8f9ceb5ffad8e7a066dfc9d9aaa5153b714740ee/500px/29-Figure10-1.png)

![[논문 리뷰] SmoothVLA: Aligning Vision-Language-Action Models with Physical ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/smoothvla-aligning-vision-language-action-models-with-physical-constraints-via-intrinsic-smoothness-optimization-0.png)


![[论文评述] TriVLA: A Triple-System-Based Unified Vision-Language-Action ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/trivla-a-triple-system-based-unified-vision-language-action-model-for-general-robot-control-1.png)
![[论文评述] DA-PTQ: Drift-Aware Post-Training Quantization for Efficient ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/da-ptq-drift-aware-post-training-quantization-for-efficient-vision-language-action-models-0.png)


![[논문 리뷰] Hierarchical Vision Language Action Model Using Success and ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/hierarchical-vision-language-action-model-using-success-and-failure-demonstrations-2.png)


![[论文评述] GeneralVLA: Generalizable Vision-Language-Action Models with ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/generalvla-generalizable-vision-language-action-models-with-knowledge-guided-trajectory-planning-0.png)

![[논문 리뷰] XR-1: Towards Versatile Vision-Language-Action Models via ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/xr-1-towards-versatile-vision-language-action-models-via-learning-unified-vision-motion-representations-0.png)

![[논문 리뷰] Sigma: The Key for Vision-Language-Action Models toward ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/sigma-the-key-for-vision-language-action-models-toward-telepathic-alignment-1.png)
![[PDF] Vision-Language-Action (VLA) Models: Concepts, Progress ...](https://figures.semanticscholar.org/b2f4aa849f1e06436d4cd4b76c43413076128ba8/24-Figure16-1.png)


![[PDF] Fine-Tuning Vision-Language-Action Models: Optimizing Speed and ...](https://figures.semanticscholar.org/5088b84507462bf725bb4898623d1dead4c6a206/9-Figure6-1.png)

![[논문 리뷰] Discrete Diffusion for Reflective Vision-Language-Action Models ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/discrete-diffusion-for-reflective-vision-language-action-models-in-autonomous-driving-3.png)
![[论文评述] Latent Bridge: Feature Delta Prediction for Efficient Dual ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/latent-bridge-feature-delta-prediction-for-efficient-dual-system-vision-language-action-model-inference-0.png)

![[PDF] Vision-Language-Action (VLA) Models: Concepts, Progress ...](https://figures.semanticscholar.org/b2f4aa849f1e06436d4cd4b76c43413076128ba8/10-Figure10-1.png)
![[Literature Review] Survey of Vision-Language-Action Models for ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/survey-of-vision-language-action-models-for-embodied-manipulation-2.png)


![[논문 리뷰] SafeVLA: Towards Safety Alignment of Vision-Language-Action ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/safevla-towards-safety-alignment-of-vision-language-action-model-via-safe-reinforcement-learning-1.png)
![[Literature Review] Tactile-Force Alignment in Vision-Language-Action ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/tactile-force-alignment-in-vision-language-action-models-for-force-aware-manipulation-1.png)


![[论文评述] Model-agnostic Adversarial Attack and Defense for Vision ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/model-agnostic-adversarial-attack-and-defense-for-vision-language-action-models-2.png)

![[論文レビュー] Pure Vision Language Action (VLA) Models: A Comprehensive Survey](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/pure-vision-language-action-vla-models-a-comprehensive-survey-0.png)
![[论文评述] Think Twice, Act Once: Token-Aware Compression and Action Reuse ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/think-twice-act-once-token-aware-compression-and-action-reuse-for-efficient-inference-in-vision-language-action-models-1.png)
![[Literature Review] AugVLA-3D: Depth-Driven Feature Augmentation for ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/augvla-3d-depth-driven-feature-augmentation-for-vision-language-action-models-1.png)
![[논문 리뷰] RoboNurse-VLA: Robotic Scrub Nurse System based on Vision ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/robonurse-vla-robotic-scrub-nurse-system-based-on-vision-language-action-model-0.png)
![[논문 리뷰] WMPO: World Model-based Policy Optimization for Vision-Language ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/wmpo-world-model-based-policy-optimization-for-vision-language-action-models-1.png)


![[논문 리뷰] QDepth-VLA: Quantized Depth Prediction as Auxiliary Supervision ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/qdepth-vla-quantized-depth-prediction-as-auxiliary-supervision-for-vision-language-action-models-2.png)


![[论文评述] EVOLVE-VLA: Test-Time Training from Environment Feedback for ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/evolve-vla-test-time-training-from-environment-feedback-for-vision-language-action-models-1.png)