Image to Text Analysis using Vision Encoder Decoder Model | by ...
Kitchens4,222 ideas

Bathrooms2,442 ideas
Kids Rooms1,868 ideas
Bedrooms1,657 ideas
Powder Rooms1,638 ideas
Family Rooms1,414 ideas
Dining Rooms1,403 ideas
Laundry1,361 ideas
Basements1,338 ideas
Entries1,286 ideas
Home Bars1,168 ideas
Hallways1,131 ideas
Home Offices1,098 ideas
Living Rooms1,038 ideas
Nurseries923 ideas
Closets & Storage922 ideas
Sunrooms851 ideas
Decks792 ideas
“Vision Encoder Text Decoder”
0 in catalog · +119 from web
More from the web

Image Captioning Using Hugging Face Vision Encoder Decoder — Step 2 ...

UNIT: Unifying Image and Text Recognition in One Vision Encoder

UNIT; Unifying Image and Text Recognition in One Vision Encoder - AAA ...

Image Captioning Using Hugging Face Vision Encoder Decoder — A Step 2 ...

UNIT: Unifying Image and Text Recognition in One Vision Encoder

Text Decoder And Encoder for PC | Encodes and decodes text - Vovsoft

Fxmarty Tiny Doc Qa Vision Encoder Decoder - a Hugging Face Space by ...

(PDF) A Novel Encoder Decoder Architecture with Vision Transformer for ...

Multi-Modal AI: Combining Text and Vision | AI Tutorial | Next Electronics

A Guide to Implement the Vision Encoder for LLaVA | Medium
Our SAE architecture based on Vision Transformer. The encoder is ...

Illustration of Vision Decoder. The vision decoder consists of a ...

Putting Encoder - Decoder Together - Scaler Topics

Understanding Encoder And Decoder LLMs

Illustration of Vision Decoder. The vision decoder consists of a ...

Overview of VT-CLIP where text encoder and visual encoder refers to the ...

Overview of VT-CLIP where text encoder and visual encoder refers to the ...

Understanding Encoder And Decoder LLMs

Encoder Decoder Architecture. | Download Scientific Diagram
(a) Encoder of Vision Transformer (ViT) [18] inspired by the encoder of ...

Paper page - UNIT: Unifying Image and Text Recognition in One Vision ...

Explain The Difference Between Encoder And Decoder In Communication at ...

Vision and Language – Foundations of Computer Vision

Vision Transformer Image Classification | MindSpore 2.0 Tutorials ...

[2310.04655] VLAttack: Multimodal Adversarial Attacks on Vision ...

Vision Transformers: From Idea to Applications (Part Four)

Handwritten Document Recognition Using Pre-trained Vision Transformers ...

Figure 1 from Bengali Image Captioning Using Vision Encoder-Decoder ...

Vision Transformers: From Idea to Applications (Part Four)

(PDF) Bengali Image Captioning Using Vision Encoder-Decoder Model

Vision Language Models (VLMs) Explained | DataCamp

The overall architecture of our proposed approach, where the vision ...

Enhancing Visual Image Captioning with SWIN Vision Transformers ...

Speed-Up Pre-trained Vision Encoder–Decoder Transformers by Leveraging ...

Image Classification with Vision Transformers | Practical Machine Learning

Chapter 8, Machine Learning and Computer Vision – Vision Readings

Figure 1 from Vision Encoder-Decoder Models for AI Coaching | Semantic ...

Figure 2 from Bengali Image Captioning Using Vision Encoder-Decoder ...

computer vision transformers: ViT does not have a decoder? - Data ...

Encoder-Decoder LSTM-RNN Model for Text Summarization. | Download ...
GPT and other LLM’s: decoder only v/s encoder-decoder models? | by ...

Figure 1 from Bridging Vision and Language Encoders: Parameter ...

26. Vision Language Pretraining — LLM Foundations

Figure 1 from VL-Reader: Vision and Language Reconstructor is an ...

FastVLM: Efficient Vision Encoding for Vision Language Models - Apple ...

(PDF) Bengali Image Captioning Using Vision Encoder-Decoder Model

End-to-End Image Captioning Using Computer Vision and Natural Language ...

An Intuitive Introduction to the Vision Transformer - Thalles' blog

A Comparative Evaluation of Transformer-Based Vision Encoder-Decoder ...

Vision and Language – Foundations of Computer Vision

Enhancing Scene Text Recognition with Encoder–Decoder Interactive Model

Figure 1.1 from Vision Encoders in Visual Question Answering | Semantic ...

it's raining vision language models ☔️ CuMo is a new vision language ...

【论文阅读笔记】A Recent Survey of Vision Transformers for Medical Image ...

Vision Language Models là gì? Nguyên lý hoạt động, lợi ích và ứng dụng

Figure 1 from A Comparative Evaluation of Transformer-Based Vision ...

Computer vision for brand protection | Image searching

Vision Transformer with Convolutional Encoder-Decoder for Hand Gesture ...

Enhanced Attention-Based Encoder-Decoder Framework for Text Recognition

Table IV from Bengali Image Captioning Using Vision Encoder-Decoder ...

Vision Transformer with Convolutional Encoder-Decoder for Hand Gesture ...

MaMMUT: A simple vision-encoder text-decoder architecture for ...

Image Captioning using PyTorch and Transformers in Python - The Python Code

MaMMUT: A simple vision-encoder text-decoder architecture for ...

MaMMUT: A simple vision-encoder text-decoder architecture for ...

Automatic Code Generation from GUI Screenshots with Vision-Language ...

BLIP: Bootstrapped Language-Image Pretraining | AI Tutorial | Next ...

The Illustrated Image Captioning using transformers - Ankur | NLP ...

HorayAI - Production Ready Cloud with Low Cost

Shrinking the Impossible (Part 2): Teaching Chatbots to See with LLaVA ...

[1909.11059] Unified Vision-Language Pre-Training for Image Captioning ...

Examples of the two vision-language understanding tasks. For VQA ...

An Unsupervised Method for Industrial Image Anomaly Detection with ...

Unleashing Large-Scale Video Generative Pre-training for Visual Robot ...
The MaMMUT model is a simple vision-encoder and text-decoder ...

论文阅读:An Empirical Study of Training End-to-End Vision-and-Language ...

Visual Transformers: How an architecture designed for NLP enters the ...

Encoder-decoder architecture used for transforming visual spectrum to ...

[2308.15996] DTrOCR: Decoder-only Transformer for Optical Character ...

Encoder-Decoder model architecture for training. | Download Scientific ...

Machine-vision based encoder-decoder convolutional neural networks ...

Explain the Transformer Architecture (with Examples and Videos) - AIML.com

Aman's AI Journal • Primers • Document Intelligence

Aman's AI Journal • Primers • Document Intelligence

LMDrive

The MaMMUT model is a simple vision-encoder and text-decoder ...

DeepSeek-OCR: Beyond Traditional OCR | Gian Paolo Santopaolo

fxmarty/tiny-doc-qa-vision-encoder-decoder at main

LeroyDyer/SpydazWeb_Speech_Vision_EncoderDecoder_Multimodal_5b_Project ...

大模型开发 - 一文搞懂Encoder-Decoder工作原理_encoder-decoder模型架构-CSDN博客
Vision-Encoder-Decoder-Benchmark/README.md at main · keqixiaojie/Vision ...

Qwen2.5-VL-3B-Instruct — PaddleNLP 文档

Unlocking Vision-Text Dual-Encoding: Multi-GPU Training of a CLIP-Like ...

saeidmp/fxmarty-tiny-doc-qa-vision-encoder-decoder at main

Prompt-Enhanced Generation for Multimodal Open Question Answering

Voice at the wheel: Study introduces an encoder-decoder framework for ...

Aman's AI Journal • Primers • Document Intelligence

Encoder-decoder architecture used for transforming visual spectrum to ...

Encoder-Decoder Models là gì? Vai trò & Ứng dụng (NPL/học máy) - Khoa ...

Introduction to LLMs: The RNN Encoder-Decoder Architecture
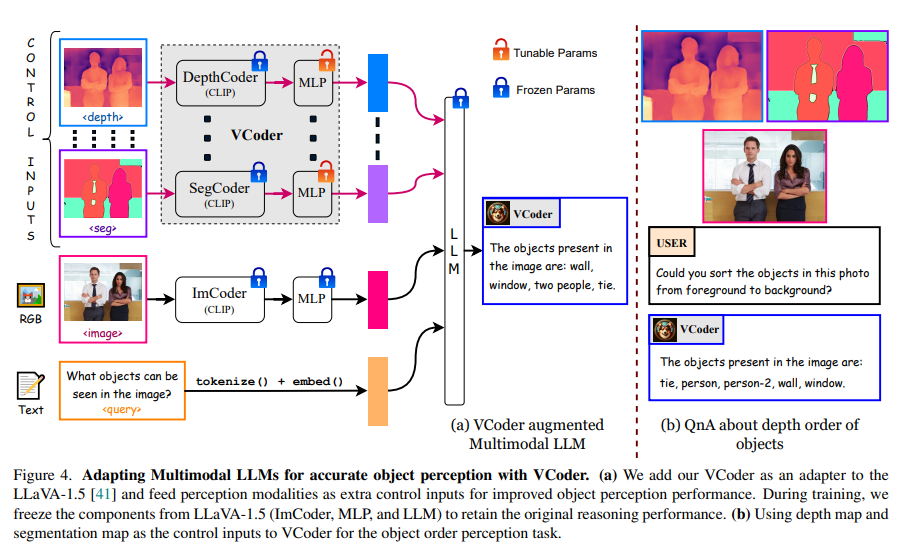
Researchers from Microsoft and Georgia Tech Introduce VCoder: Versatile ...

Vision–Language Model for Visual Question Answering in Medical Imagery

Unveiling Encoder-Free Vision-Language Models
GitHub - kevin801221/EEG-Vision-Encoder_Decoder-Structure-design: 為了實現 ...

MaMMUT: A simple vision-encoder text-decoder architecture for ...

Google DeepMind Research Releases SigLIP2: A Family of New Multilingual ...

Autoencoders in Computer Vision: A Deep Learning Approach for Image ...

Encoder-Decoder Models - Naukri Code 360

Auto Tagging Videos with Vision-Language Models | AI Tutorial | Next ...

[2208.09596] Vision-Language Matching for Text-to-Image Synthesis via ...

VLMT: Vision-Language Multimodal Transformer for Multimodal Multi-hop ...

Autoencoders in Computer Vision: A Deep Learning Approach for Image ...

Zero-shot Image Classification with OpenAI's CLIP | Pinecone

MaMMUT: A simple vision-encoder text-decoder architecture for ...

MaMMUT: A simple vision-encoder text-decoder architecture for ...

Autoencoders in Computer Vision: A Deep Learning Approach for Image ...

Transformer-based Encoder-Decoder Models

Figure 1 from Scheduled Sampling in Vision-Language Pretraining with ...