High Parameter Vision Encoder Models - a Brandonioti Collection

Kitchens4,222 ideas

Bathrooms2,442 ideas

Kids Rooms1,868 ideas

Bedrooms1,657 ideas

Powder Rooms1,638 ideas

Family Rooms1,414 ideas

Dining Rooms1,403 ideas

Laundry1,361 ideas

Basements1,338 ideas

Entries1,286 ideas

Home Bars1,168 ideas

Hallways1,131 ideas

Home Offices1,098 ideas

Living Rooms1,038 ideas

Nurseries923 ideas

Closets & Storage922 ideas

Sunrooms851 ideas

Decks792 ideas
“Vision Encoder Models”
0 in catalog · +119 from web
More from the web

Figure 1 from Vision Encoder-Decoder Models for AI Coaching | Semantic ...

Meta AI Introduces Perception Encoder: A Large-Scale Vision Encoder ...

Florence-VL: Enhancing Vision-Language Models with Generative Vision ...

自动驾驶VLA简单调研--Part1 Vision Encoder - 知乎
(a) Encoder of Vision Transformer (ViT) [18] inspired by the encoder of ...

FastVLM: Efficient Vision Encoding for Vision Language Models | Vuink.com

Hierarchical Pre-Training of Vision Encoders with Large Language Models

Bambu Lab Vision Encoder fyrir H2 — 3D VERK

Vision Language Models (VLMs) Explained | DataCamp

Vision Language Models (VLM) Là Gì? Đặc Tính Và Ưu Điểm

NVIDIA’s C-RADIOv3 is the Vision Encoder You Should Be Using

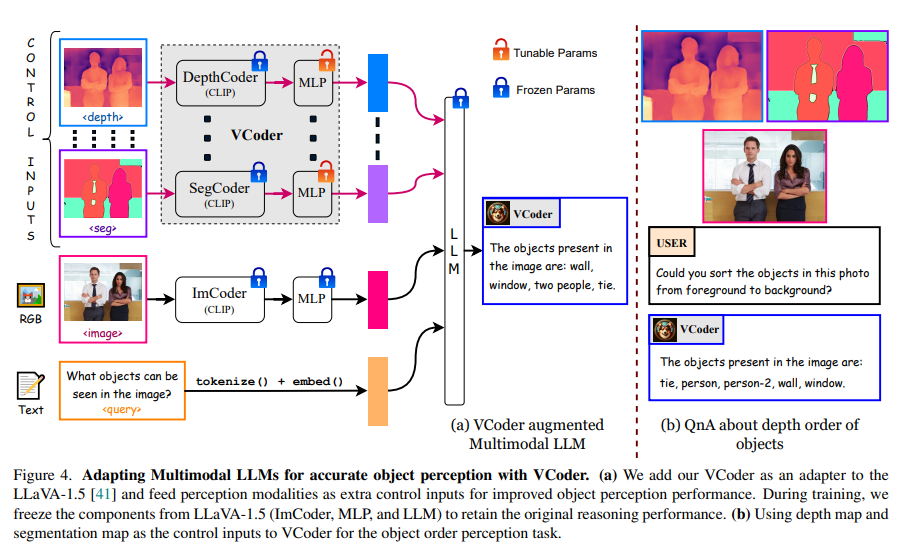
VCoder: Versatile Vision Encoders for Multimodal Large Language Models ...

Florence-VL: Enhancing Vision-Language Models with Generative Vision ...

VLM 中的 Vision encoder 回顾 - 知乎

FIGURE Structure of encoder layer in Vision Transformer. | Download ...

Best Computer Vision Models | Encord

Meta AI Introduces Perception Encoder: A Large-Scale Vision Encoder ...

Image Captioning Using Hugging Face Vision Encoder Decoder — A Step 2 ...

General Vision Encoder Features as Guidance in Medical Image ...

(a) Encoder block, (b) Vision transformer. | Download Scientific Diagram

ADJ 3D Vision Encoder User Manual
![[論文レビュー] An Efficient and Effective Encoder Model for Vision and ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/an-efficient-and-effective-encoder-model-for-vision-and-language-tasks-in-the-remote-sensing-domain-0.png)
[論文レビュー] An Efficient and Effective Encoder Model for Vision and ...

Securing Vision-Language Models with a Robust Encoder Against Jailbreak ...

Vision Language Models Là Gì? GPT 4o Có Phải Là VLMs Không?

Experiment of 3D vision encoder network with different number of ...

Vision Encoder | Bambu Lab US Store

Representation in Vision Transformers and Attentionless Models | Form ...

Understanding Vision Language Models

Meta AI Releases EUPE: A Compact Vision Encoder Family Under 100M ...

What Are Visual Language models (VLMs) And How Do They Work? - TopDailyBlog

Vision Transformer (ViT) Architecture | GeeksforGeeks
Schematic of Vision Transformer Encoder. | Download Scientific Diagram

Vision Transformer Image Classification | MindSpore 2.0 Tutorials ...

Stateful Visual Encoders for Vision-Language Models

Unveiling Encoder-Free Vision-Language Models | AI Research Paper Details

Handwritten Document Recognition Using Pre-trained Vision Transformers ...

Figure 1 from Bengali Image Captioning Using Vision Encoder-Decoder ...

(PDF) Bengali Image Captioning Using Vision Encoder-Decoder Model

Vision Transformers: From Idea to Applications (Part Four)

The overall architecture of our proposed approach, where the vision ...

Figure 1.1 from Vision Encoders in Visual Question Answering | Semantic ...

An Intuitive Introduction to the Vision Transformer - Thalles' blog

Most current models that handle both image understanding and image ...

Figure 1.1 from Vision Encoders in Visual Question Answering | Semantic ...

Schematic representation of vision transformer encoder. | Download ...
![[2307.13721] Foundational Models Defining a New Era in Vision: A Survey ...](https://ar5iv.labs.arxiv.org/html/2307.13721/assets/figs/vl_model_types.png)
[2307.13721] Foundational Models Defining a New Era in Vision: A Survey ...

Vision Transformers (ViT) Explained | Pinecone

Vision Transformers: From Idea to Applications (Part Four)

EVEv2: Improved Baselines for Encoder-Free Vision-Language Models · HF ...
![[2502.15969] Forgotten Polygons: Multimodal Large Language Models are ...](https://ar5iv.labs.arxiv.org/html/2502.15969/assets/figures/encoder_embeds.png)
[2502.15969] Forgotten Polygons: Multimodal Large Language Models are ...

A Comparative Evaluation of Transformer-Based Vision Encoder-Decoder ...

Vision Transformer(2021) 논문 리뷰

Figure 2 from Bengali Image Captioning Using Vision Encoder-Decoder ...

An Intuitive Introduction to the Vision Transformer - Thalles' blog

Introducing Efficient Universal Perception Encoder (EUPE)🚀 A family of ...

OneVision-Encoder A vision architecture that aligns with information ...

Vision Transformers - by Cameron R. Wolfe, Ph.D.

Investigating Redundancy in Multimodal Large Language Models with ...

Stealthy Backdoor Attack in Self-supervised Vision Encoders for Large ...

Putting Encoder - Decoder Together - Scaler Topics

Comparing Vision Transformers and Convolutional Neural Networks for ...

Vision Transformer Based Model for Describing a Set of Images as a ...

Figure 1 from A Comparative Evaluation of Transformer-Based Vision ...

Apple Releases AIMv2: A Family of State-of-the-Art Open-Set Vision ...

The overall architecture of our proposed approach, where the vision ...

Cross-aware Early Fusion with Stage-divided Vision and Language ...

Figure 1 from UNIT: Unifying Image and Text Recognition in One Vision ...

The structure of Vision Transformer Encoder. | Download Scientific Diagram

【论文笔记】Florence-VL: Enhancing Vision-Language Models with Generative ...

Overview of VT-CLIP where text encoder and visual encoder refers to the ...
![[25,1] VideoLLaMA 3: Frontier Multimodal Foundation Models for Image ...](https://velog.velcdn.com/images/hsbc/post/ecd30db4-454c-41f5-b1c3-91ab3d38cc97/image.png)
[25,1] VideoLLaMA 3: Frontier Multimodal Foundation Models for Image ...

a: The CSF of CLIP vision-language models with two different image ...

Speed-Up Pre-trained Vision Encoder–Decoder Transformers by Leveraging ...

iGVLM: Dynamic Instruction-Guided Vision Encoding for Question-Aware ...

Figure 2 from A Comparative Study of Vision Transformer Encoders and ...

斯坦福伯克利揭露MLLM vision encoder的秘密:Law of Vision Representation in MLLMs - 知乎
Left: The structure of the deformable vision transformer encoder. It is ...
![[2412.04424] Florence-VL: Enhancing Vision-Language Models with ...](https://ar5iv.labs.arxiv.org/html/2412.04424/assets/x5.png)
[2412.04424] Florence-VL: Enhancing Vision-Language Models with ...

Vision Transformers Explained at Hunter Berry blog

Paper Review: Unveiling Encoder-Free Vision-Language Models – Andrey ...

【论文阅读笔记】A Recent Survey of Vision Transformers for Medical Image ...

Schematic diagram of Vision Transformer Encoder. | Download Scientific ...

Biomimicry: Nature's Blueprint for AI Vision Innovation

Image Captioning using PyTorch and Transformers in Python - The Python Code

What is Phi-3.5-vision?. Explained with Working Examples | by Research ...

LMDrive

HorayAI - Production Ready Cloud with Low Cost

Unlocking Vision-Text Dual-Encoding: Multi-GPU Training of a CLIP-Like ...

GeorgyGUF/Qwen2.5-VL-72B-Instruct-bf16.gguf · Hugging Face

MaMMUT: A simple vision-encoder text-decoder architecture for ...
Researchers from Microsoft and Georgia Tech Introduce VCoder: Versatile ...

DeepSeek-OCR: Beyond Traditional OCR | Gian Paolo Santopaolo

An Unsupervised Method for Industrial Image Anomaly Detection with ...

Demystifying Vision-Language Models: An In-Depth Exploration - MarkTechPost
![[2304.06286] Automated Cardiovascular Record Retrieval by Multimodal ...](https://ar5iv.labs.arxiv.org/html/2304.06286/assets/figs/model.png)
[2304.06286] Automated Cardiovascular Record Retrieval by Multimodal ...

The Illustrated Image Captioning using transformers - Ankur | NLP ...

Medium

High-Level Visual Encoding Model Framework with Hierarchical Ventral ...

Machine-vision based encoder-decoder convolutional neural networks ...
![[paper reading] Unveiling Encoder-Free Vision-Language Models(无编码器视觉语言 ...](https://pic4.zhimg.com/v2-ad0fc88dcb43476e587b9be486383f97_r.jpg)
[paper reading] Unveiling Encoder-Free Vision-Language Models(无编码器视觉语言 ...

Aman's AI Journal • Primers • Document Intelligence

FastVLM, a Vision-Language Model - CVPR 2025 - MLWires

Visual Transformers: How an architecture designed for NLP enters the ...

Distilled Dual-Encoder Model for Vision-Language Understanding 解读 - 知乎
![[2404.07204] BRAVE : Broadening the visual encoding of vision-language ...](https://ar5iv.labs.arxiv.org/html/2404.07204/assets/x2.png)
[2404.07204] BRAVE : Broadening the visual encoding of vision-language ...

VLA论文精读(十四)PointVLA: Injecting the 3D World into Vision-Language-Action ...

Encoder-decoder architecture used for transforming visual spectrum to ...
GPT and other LLM’s: decoder only v/s encoder-decoder models? | by ...

Bambu Lab H2S 3D Drucker: Single-Extruder mit großem Bauraum

Paper page - OpenVision 2: A Family of Generative Pretrained Visual ...

An End-to-End Framework Based on Vision-Language Fusion for Remote ...
![[2501.10071] CLIP-PCQA: Exploring Subjective-Aligned Vision-Language ...](https://ar5iv.labs.arxiv.org/html/2501.10071/assets/figs/vit.png)
[2501.10071] CLIP-PCQA: Exploring Subjective-Aligned Vision-Language ...
![[2603.02270] 1 Introduction](https://ar5iv.labs.arxiv.org/html/2603.02270/assets/sections/figures/tsne_comparison_vision_encoders.png)
[2603.02270] 1 Introduction
![[论文笔记][Vision Encoders in Vision-Language Models_ A Survey] - 知乎](https://picx.zhimg.com/v2-5a59c535ebb6d9a97e704e7139a1fe29_1440w.jpg)
[论文笔记][Vision Encoders in Vision-Language Models_ A Survey] - 知乎

Aman's AI Journal • Primers • Document Intelligence

Bambu Lab H2D 3D Printer– Ultimate 3D Printing Store